
エラーで止まるように作ったcronが誰も見ないログに失敗を記録し続けていた話
動画チャンネルの公開後処理を、LLMを使わないシンプルなシェルスクリプトとcronで30分おきに動かしています。役目を終えた一時スクリプトが自動削除された翌朝、残った本番cronが401エラーで落ち始めました。安全にエラー終了させたはずが、誰も確認していないログファイルにエラーが溜まり続けていた失敗と、最終的に通知を日常の git status に接続した記録です。
「自動化エージェントが一晩で23ドルを溶かした話」では、AIエージェントが自ら設定したcronジョブが一晩でAPIクレジットを使い果たした失敗を振り返り、定期実行のスクリプトにはLLMを挟まないというルールを決めました。
いまも「歴史の雨音」の公開後処理は、LLMを一切介さないシンプルなシェルスクリプトを使い、30分おきにcronで動かしています。このcronジョブでは、YouTubeで新しいショート動画が公開されたら、長尺動画の紹介のコメントを追加し、Instagram Reelsへと転送するというタスクを行なっています。
この記事は、この自動化スクリプトを10月に運用していてうまくいった部分と、思わぬ盲点に気づいた記録です。
5月の事故のあと、定期実行の処理にはLLMを挟まないようにして運用を続けてきました。勝手にAPIを叩きまくるような暴走は防げるようになったのですが、当たり前ですが、バックグラウンドで動いている処理を人間が四六時中見張っているわけでもありません。安全にエラー終了するように作ったとしても、その失敗に人間が気づかなければ意味がないという、ごく基本的な問題に後から直面することになりました。
役目を終えたら自分を消すスクリプト
8月にInstagramへの自動投稿を始めた際、YouTubeですでに公開済みだった過去のショート動画33本が、Instagram側に未投稿のまま残っていました。日々の監視スクリプトは直近3日以内に公開された動画しか処理しないため、この33本はそのままでは投稿されずに残っていました。
そこで、1日あたり数本ずつ過去動画を遡ってReelsに投稿し、すべて投稿し終えたら自分のジョブ登録をcrontabから自動で削除する一時的なスクリプトを作りました。
いくつか気をつけて設計した点があります。
ひとつは、処理対象の動画リストを実行開始時にテキストファイルとして固定したことです。毎回APIを叩いて動的に対象を計算させると、新しく公開された動画を巻き込んで終了条件が曖昧になったり、本番の定期スクリプトと処理が重複したりするリスクがあるからです。
もうひとつは、期限を日数ではなく「完了した本数」でカウントしたことです。途中でネットワークエラーやAPI制限で投稿が失敗した日があっても、全体の終了が後ろにずれるだけで、投稿すべき本数が漏れることはありません。
そして、crontab から自分を削除する処理は、crontab -l で既存の設定を正常に読み出せたときだけ実行するようにガードをかけました。
このバックフィル処理は、10日ほどかけて計画通りに33本をすべて投稿し終え、最後に以下のログを残してcrontabから自動で削除されました。
2026-10-07 19:11:18  backfill edo_kyoto_machiya  posted  18639591748050694
2026-10-07 19:11:18  backfill BACKFILL COMPLETE
2026-10-07 19:11:18  backfill complete — removed the cron entry, nothing left to post
計画通りに終了し、crontabには本番用の定期監視スクリプトだけが残る状態になりました。
翌朝401エラーで落ち始める
ところがその日の深夜、10月8日の午前4時30分から、残った本命のcronがエラーを出し始めました。
2026-10-08 04:30:02  FAIL  youtube comment
2026-10-08 05:00:05  FAIL  instagram reels
2026-10-08 05:30:03  FAIL  youtube comment
…
2026-10-08 12:00:04  FAIL  youtube comment
YouTube Data APIが、認証エラーを示す 401 Unauthorized を返し続けていたのです。
Instagramへの投稿もYouTubeの公開状態をトリガーにしているため一緒に止まり、公開後のバッチ処理全体が止まっていました。
エラーで終了しても誰も気づかない
このスクリプトには、以前の反省を踏まえていくつか工夫を入れていました。
cron環境下ではブラウザを使った再認証画面を決して開かないようにしたのもそのひとつです。ヘッドレスなサーバー環境でブラウザを開こうとすると、返ってこない入力を待ち続けてプロセスが止まったままになってしまうため、認証が切れたときは即座にエラー終了するようにしていました。
また、処理すべき動画がないときはログに何も書き込まないようにしていました。30分おきに「対象なし」とログを吐き続けると、ファイルが無意味な行で埋まり、ログが読みにくくなってしまうからです。
10月8日の朝、スクリプトはある意味、意図した通りに動き、ハングすることなくエラーコードを返して終了し、ログファイルには失敗の記録を行いました。
問題は、そのログの出力先が、普段開くことのないローカルファイルだったことです。
普段の開発は git status やエディタのGitパネルを見ながら進めているため、Gitの追跡対象外のログファイルは、意識して覗きに行かない限り視界に入りません。日頃から安定して動いていたスクリプトだったこともあり、毎朝わざわざそのログを開いて確認する習慣もありませんでした。
午前4時半から私が気づく昼過ぎまで、30分おきにエラーは記録されていましたが、通知の仕組みも外部の監視サービスも入れていなかったため、気づかないまま数時間が過ぎていました。
ハングせずに安全にエラー終了させることばかりに気を取られていて、日常の開発の流れの中でその失敗をどう検知するか、という視点が抜けていたのです。お恥ずかしいことですが、歴史の雨音は同時並行的にいろいろなことを試している実験場のような場所ですので、ついついいつも新しいことを試すのに頭がいっぱいで見落としていたのです。
有効なトークンが半分の確率で弾かれていた
調査してみて分かったのは、エラーの原因そのものの不可思議さでした。
トークンの期限切れを疑って再認証を行う前に、同じトークンを使ってAPIを30回連続でテストしてみたところ、妙な結果が出ました。
成功が14回、401エラーが16回。
強制的に再発行した新しいトークンでも、成功が11回、失敗が9回でした。トークン検証用のエンドポイントでは有効と判定され、マシンのシステムクロックもGoogleのサーバー時刻と秒単位で一致しています。
つまり、有効なトークンであるにもかかわらず、約半分の確率で弾かれてしまう状態になっていました。Googleの内部インフラ側で何が起きていたのかまでは分かりません。
もし「手元のトークンが壊れた」と思い込んで再認証だけして済ませていたら、原因が掴めないままだったと思います。
リトライ回数の上限を引き上げることで対応しました。使用していたGoogleの公式クライアントライブラリは、401エラー時の自動再試行が3回までに制限されており、成功率50%の環境では1回の実行が失敗に終わる確率が1割以上残ってしまいます。動画1本の処理でAPIを数十回叩くバッチ処理では、どこかで必ず引っかかって全体が停止してしまいます。
再試行の上限を10回まで引き上げたところ、テストした30回のバッチすべてが安定して成功するようになりました。
監視は git status で確認、というマニュアル的な方法に
エラーの発生にどうやって気づくか。WhatsAppにメッセージを送る、メール通知を飛ばす、SlackのWebhookを叩くといった一般的な通知も考えました。
ただ、ここで気になったのは通知の仕組み自体が壊れるリスクでした。
外部サービスのトークン切れやネットワークの瞬断、メールのスパム判定など、通知システム側が動かなくなって肝心のエラーが届かないという経験は過去にもありました。通知が正常に動いているかを監視するための仕組みを作るような堂々巡りは避けたかったのです。
外部サービスに頼らず、日常の中で無理なく気づける方法がこのプロジェクトには向いている、そうおもって、毎日の開発で必ず叩く git status で確認することにしました。
リポジトリの中に cron_health.md というファイルを1つ置き、cronが3回連続で失敗したときだけ、スクリプトがこのファイルの中身を書き換えるようにしました。
ファイルが書き換わると作業ツリーに差分が発生し、エディタのGitパネルにも未コミットの印が付きます。毎日の開発で git status を叩くかエディタを開けば、自然と目に入ります。
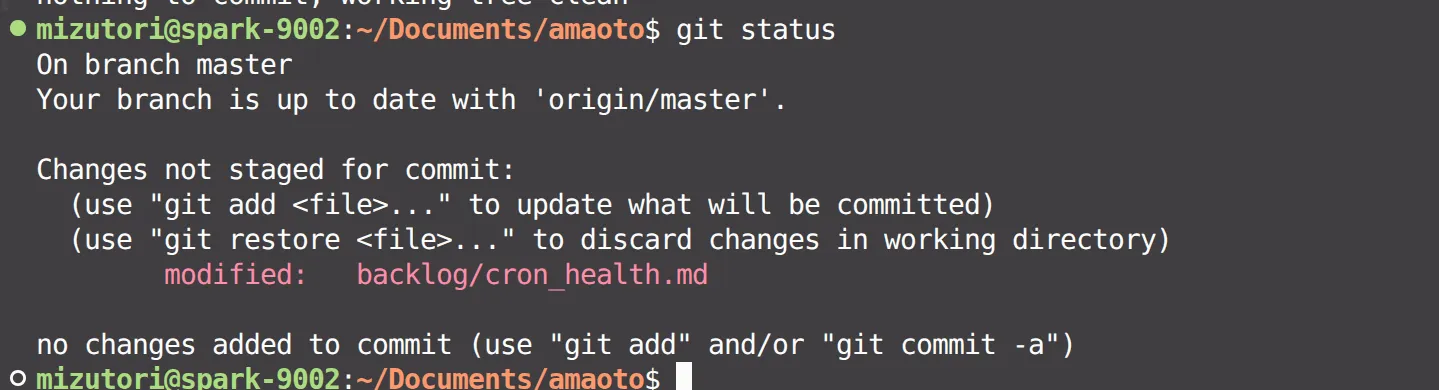

シンプルな工夫ですが、正常に動いている間はこのファイルに変更が起きないようにしました。実行日時などを毎度書き込んでしまうと常に差分が出っ放しになるため。実行が正常に成功すれば、ファイルは自動的に元の状態に戻るようにしまして、git statusに差分が出ない仕組みにしました。
以前、Instagramのトークン切れ通知を検討した際にも、「毎日Instagramの画面をチェックしているから、大げさな通知はいらない」とエージェントに話したことがありました。
通知用のツールを増やすのではなく、人間が日常的に見ている場所に最小限の仕組みで差分を出す。一見するとマニュアル的な方法ですが、今の日常の行動、習慣に一番フィットした手法が一番無駄なストレスやエネルギーを使わずに対処できます。
エラーで止まる設計と、気づく設計
定期実行のスクリプトにLLMを挟まないという判断は、今でも正しいと思っています。今回の障害対応や復旧処理も、素のシェルスクリプトの範囲で十分に完結できました。
ただ、バックグラウンドで自動実行している以上、何かが起きたときに人間がいつもその場にいるわけではありません。
プロセスが安全にエラー終了するだけでは不十分で、そのサインが特別な監視画面を開かなくても、日々の自然な仕事の流れの中で無理なく目に入るようにしておくことが非同期的な制作のポイントだと体感しました。
小規模なチームでの自動化や、過度な監視コストをかけずに障害に気づける運用設計をお考えの方は、お気軽にご相談ください。日々積み重ねている実体験からお手伝いできることがあると思います。