
全く見られなかった56言語の翻訳と初回から1000再生を超えたショート動画
雨音動画の説明文を56言語に翻訳して公開しました。しかし3ヶ月経っても海外からはほぼ見られず、そもそも発見の経路が存在していなかったことに気づいて14言語へ縮小することになります。その一方で手軽に試した縦長ショートが初回から1,000再生を超えた、プラットフォーム上での仮説検証の記録です。
YouTubeチャンネル「歴史の雨音」を始めたとき私はひとつの仮説を持っていました。雨の音には翻訳が要らないということです。映像にナレーションもテロップも入れない設計にしてあるので、タイトルと説明文さえローカライズすれば1本の動画がそのまま全世界に届くのではないか、と考えていました。
YouTubeの多言語ローカライズ機能は無料です。翻訳はAIエージェントのパイプライン(全体像はこちら)が自動で行うので、増えるコストは言語あたりAPIコール1回分だけ。それならば、届く可能性のある言語にはすべて届けてみようと考えました。
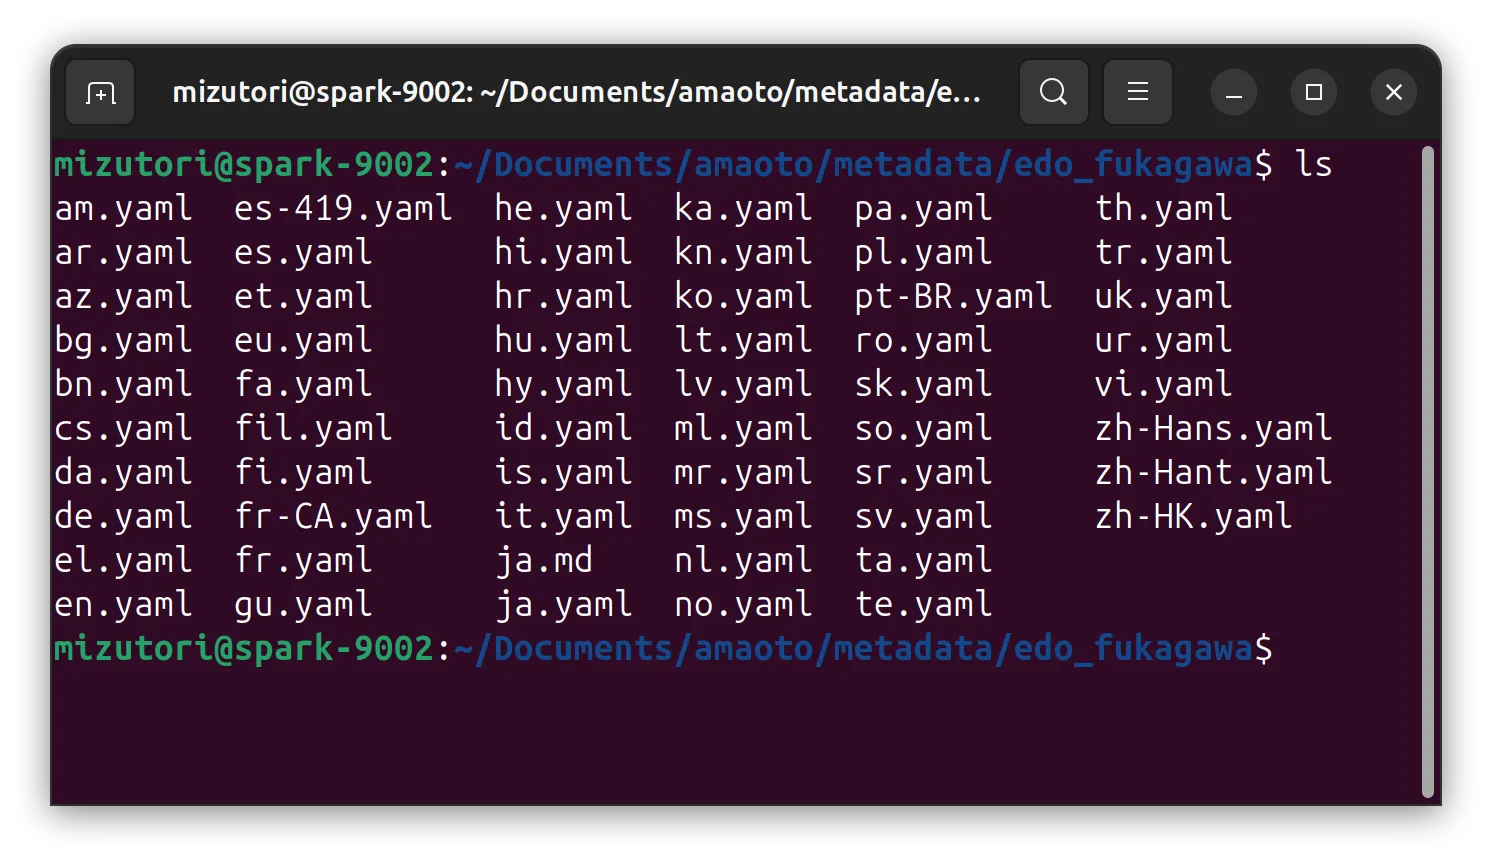
こうして最初の動画は56言語のメタデータを引き連れて公開されました。am(アムハラ語)、az(アゼルバイジャン語)、bg(ブルガリア語)、bn(ベンガル語)……アルファベット順にずらりとYAMLファイルが並びます。日本語のソースを人間が書き残り56言語のファイルは機械が生成しました。1本の動画を出力するたびにこの56言語の説明文とタイトルを生成するだけでAPIが10分以上走り続けていたのですが、これで世界中に届くなら安いものだと、当時は画面を眺めて待っていたのです。
日本と、わずかに韓国から
3ヶ月運用してみて分かった現実は渋いものでした。視聴のほぼすべてが日本からで、あとはわずかに韓国から。それ以外の54言語圏からの到達は事実上ゼロでした。
理屈の上では世界中に開かれている動画が、なぜ日本からしか観られないのか。夏休みを利用してアメリカの大学から来ていたインターン生に、YouTubeで検索してみてほしいと頼んでみました。彼が検索バーに「歴史の雨音」と入れても当然出てきません。英語で「Old Japan Rain」と検索してもヒットせず、最終的にアカウント名の「@OldJapanRain」を完全一致で打ち込んでようやく出てきました。
発見の経路そのものが存在していなかったということに始めて気づきました。
ローカライズは、見つけてもらったあとの体験を整えてはくれますが、見つけてもらうきっかけそのものを作ってくれるわけではありませんでした。推薦アルゴリズムがまだ小さなチャンネルを海外の視聴者に届けてくれない以上、毎回10分以上待って生成していた56言語の説明文は誰にも読まれる機会がなかったのです。
長尺動画の再生数は、多いもので200弱、少ないものは10回ほどでした。この数字と言語別の視聴データを前に、6月に翻訳対象を56言語から14言語に削減しました。14言語に絞ったことで、それまで10分以上かかっていたメタデータ生成は一気に短縮されパイプラインのボトルネックも解消されました。
やはり、新しいことをやるときはスモールに始めるほうが良いという学びでした。もっと少ない他言語から始めてみてテストすればよかったのですが、アムハラ語など、自分が見ることのない言語にも翻訳してみる好奇心が湧いてしまい、無駄な時間とトークンを使っていました。
雨の言語コードにまつわる仕様の罠
多言語対応を進める中で、YouTubeの仕様に振り回されたことがありました。雨音動画の「音声の言語」の設定です。
雨の音には会話がないため、ISO規格では「言語的内容なし」を意味する zxx が適切なコードです。実際、YouTube Studioの管理画面で「該当なし」を選択すると、内部的には zxx が設定されます。
ところが、YouTube Data API経由でメタデータを更新する際、この zxx を送信するとHTTP 400エラー(invalidVideoMetadata)で弾かれてしまいます。画面から設定できる値なのに、APIからは受け付けない仕様になっていたのです。そのため、アップロードスクリプトからはこのフィールドの指定を外し、Studio側のデフォルト設定に委ねることで回避しました。
その後、Claude Codeとのやり取りでも一悶着ありました。「音声言語が『該当なし』だと元言語が判定できず、海外配信で不利になるかもしれないから ja にしてみてはどうか」と提案され、試したこともあります。しかし、ja に変えても海外からのアクセスは全く増えませんでした。結局「やはり zxx に戻すべきですね」という話になり手動で戻しています。
プラットフォームの仕様もAIのアドバイスも、実際に動かして試してみなければわからないことばかりでした。
縦長のショート動画を試してみる
多言語展開と並行して、動画のフォーマットも見直すことにしました。
雨音チャンネルの長尺動画は作業用BGMとして使われることが多く、映像よりも音が主役になりがちです。しかし、せっかくAIで生成した歴史的な情景ももっと見てもらいたいと思っていました。それに、立ち上げたばかりの無名チャンネルの長尺動画は、そもそもYouTubeの検索やおすすめにほとんど載りません。一方、ショート動画はプラットフォーム側が新規の視聴者にランダムに届けてくれる仕組みがあります。
そこで、同じ歴史シーンを9:16の縦構図で出力するショート用のパイプラインを作りました。
長尺動画を作るときは15秒のクリップをffmpegで繋いで30分に引き伸ばしクロスフェードや音のループ処理を行うため数時間のアセンブル時間がかかることもありました。しかしショートなら15秒のクリップに雨音を合わせるだけです。YouTubeアプリ側が自動でループ再生してくれるため、フェードインやフェードアウトの処理すら要りません。
手間を大幅に減らして投稿してみたところ最初の1本目からいきなり1,000再生を超えました。
長尺動画の再生数が数十回から多くても200回弱だったことを考えると、文字通り桁違いの反応です。長尺のレンダリングや56言語の翻訳にかけていた時間は何だったのかと思いましたが、無名の新規チャンネルにとってショート動画の拡散力は圧倒的でした。
ここから運用方針を「ショートを中心に高頻度で投稿し、長尺はたまに作る」形に切り替え、1本あたり12分ほどで下書きまで自動生成できる体制を作っていきました。
実際に公開した最初のショート動画がこちらです。
もう一度予想が外れた猫のパラメータ
ショートの運用を続ける中でもうひとつ予想外のことがありました。
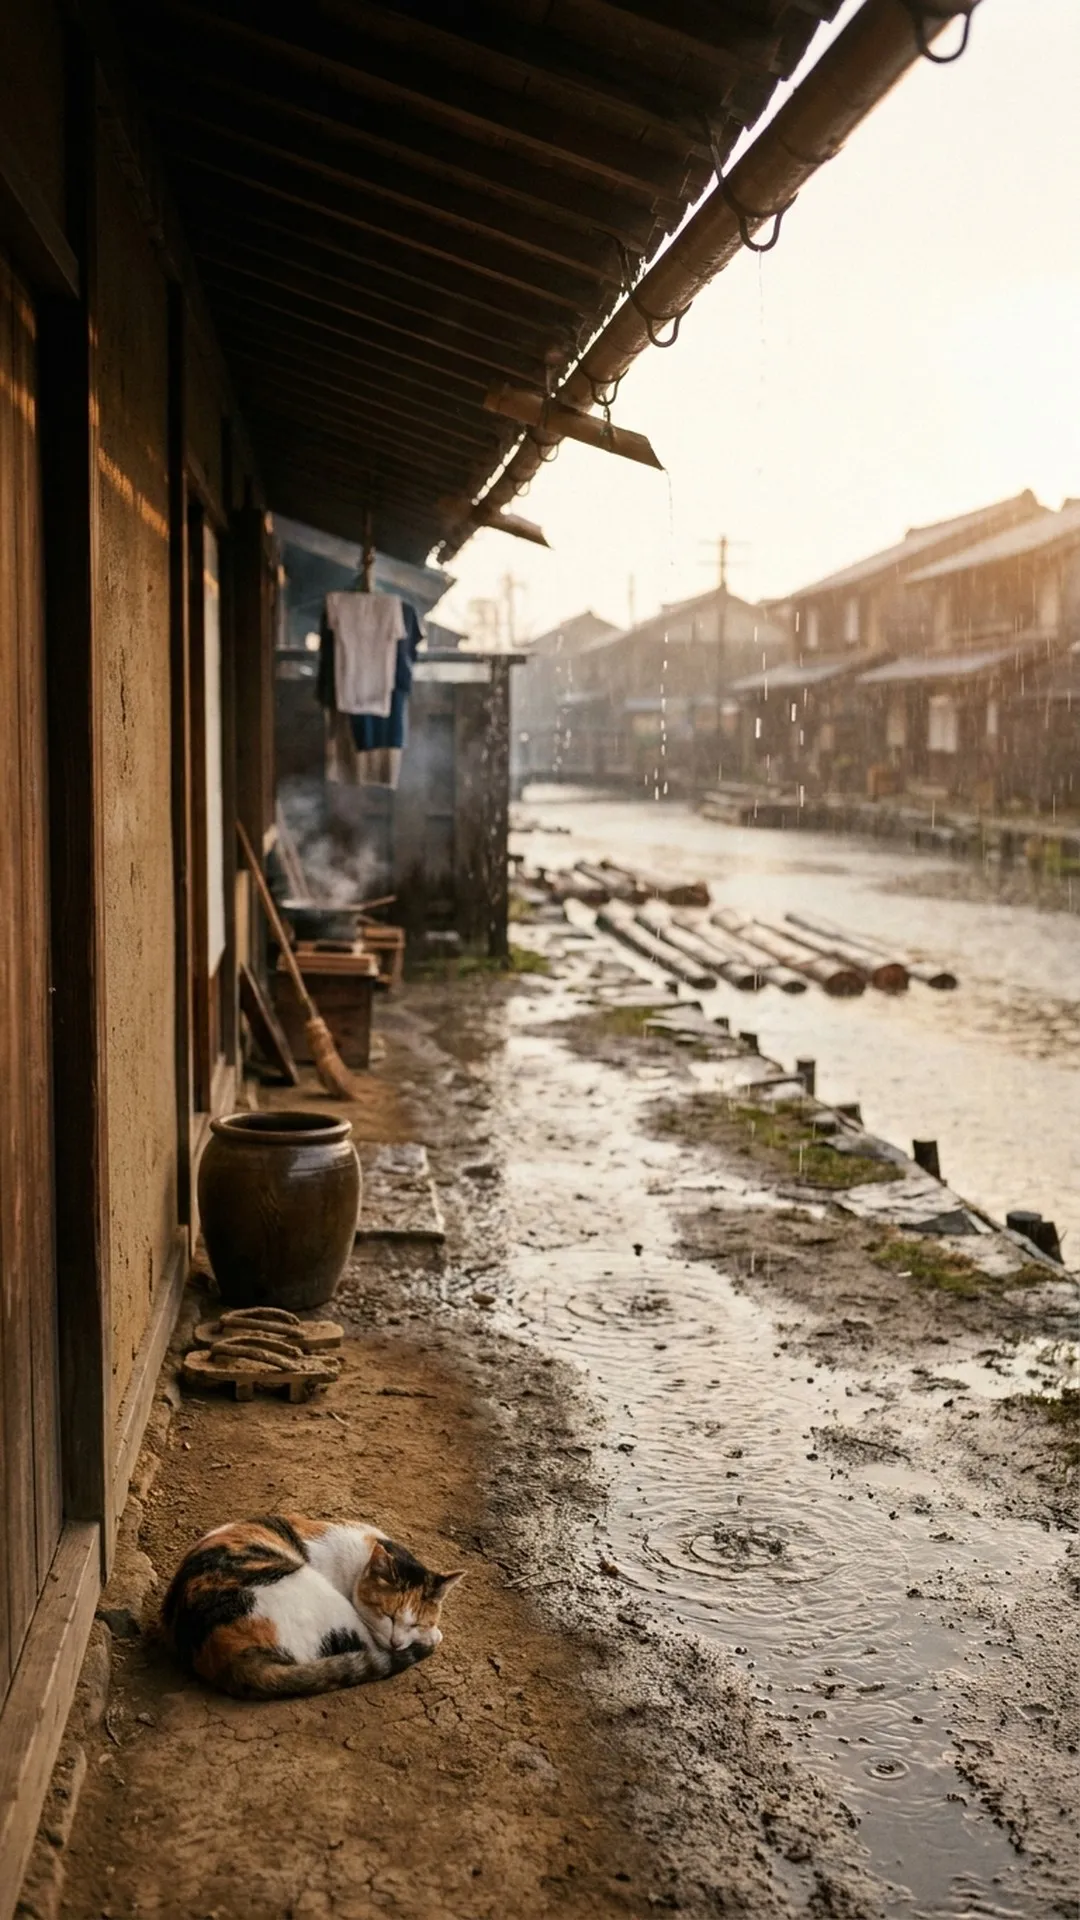
7月末、軽い気持ちでシーンの中に猫を配置できる cat パラメータをパイプラインに追加してみました。すると、猫が登場する動画だけ明らかに再生数が伸びたのです。
効果を確かめるため制作するショートのうち猫を出す割合を16%から50%まで引き上げてみました。半々で投稿してみれば猫の効果がどれくらいあるのか数字で比較できると考えたからです。
一連の実験でわかったこと
今回の試行錯誤から学んだことは大きく3つあります。
1つ目は、プラットフォーム上での仮説は実際に出してみるまでわからないということです。多言語翻訳も、ショートへの切り替えも、猫の追加も、机の上でいくら議論しても正解は出ませんでした。数ヶ月運用して実際の視聴データを見て、ようやく結果がわかりました。
2つ目は、新しい施策を試すコストが低ければ気軽に実験し、やめる判断はデータを見て冷静に下すということです。56言語の翻訳はコストがほぼかからなかったからこそ試せましたし、数字が出なかった時点で14言語に縮小しました。
3つ目は、「見つけてもらう仕組み」と「見てもらったあとの体験」は別物だということです。多言語化は見つけてもらったあとの体験を良くするものであって、最初の発見を生み出すものではありませんでした。無名のアカウントがプラットフォーム上で見つけてもらうためには、ショートのような拡散力のあるフォーマットを選ぶ必要がありました。
プロダクトの仮説検証や、AIエージェントを用いた自動化パイプラインの設計など、実体験に基づいた開発にご興味のある方は、お気軽にお問い合わせください。