
全自動化のなかに人間の手仕事を置く ― 27個の雨音に1つ1つメタデータを振った話
AIエージェントが動画チャンネルをほぼ全自動で回すパイプラインの中で、あえて人間の手作業に残した仕事についてを書きます。27個の雨音をひとつずつ耳で聴いてメタデータを振り、Adobe Auditionのスペクトログラムで虫の鳴き声を消していく。自動化の中身は実際は人間の判断の集積で、どこに人間の確認を置くかで設計が決まるものだと、いまは考えています。
YouTubeチャンネル「歴史の雨音」は、画像生成からアップロードまでをAIエージェントがほぼ全自動で回しています(全体像はこちら)。本日はその逆側——あえて自動化しなかった仕事について書いてみたいと思います。
全自動パイプラインの品質は、自動化された部分の性能で決まると思われがちですが、5ヶ月運用しての実感は違いました。品質を決めていたのは、人間の手作業をどこに、どの形で残すかでした。
雨の音だけは実録音を使う
このチャンネルの映像はAI生成ですが、雨の音は違います。動画生成モデルが同時に生成するネイティブ音声は使わず、実録音のロイヤリティフリー音源を別途用意して重ねる。これはチャンネル開設時に決めた原則です。
そして音源はダウンロードしたままでは使わず、Adobe Auditionでの一手間編集が入ります。
- 音量レベルの調整 — 突発的に大きな音が入らないように均す
- フェードイン・アウトのカット — ループで使うとき繋ぎ目が自然になるように
- 安定部分の抽出 — 雷などが入っていない一定した雨音の区間だけを切り出す
- ノイズの除去 — スペクトログラム上でノイズをひとつずつマークして消していく。猿の鳴き声が入っていたこともありましたがそういうものを消します。
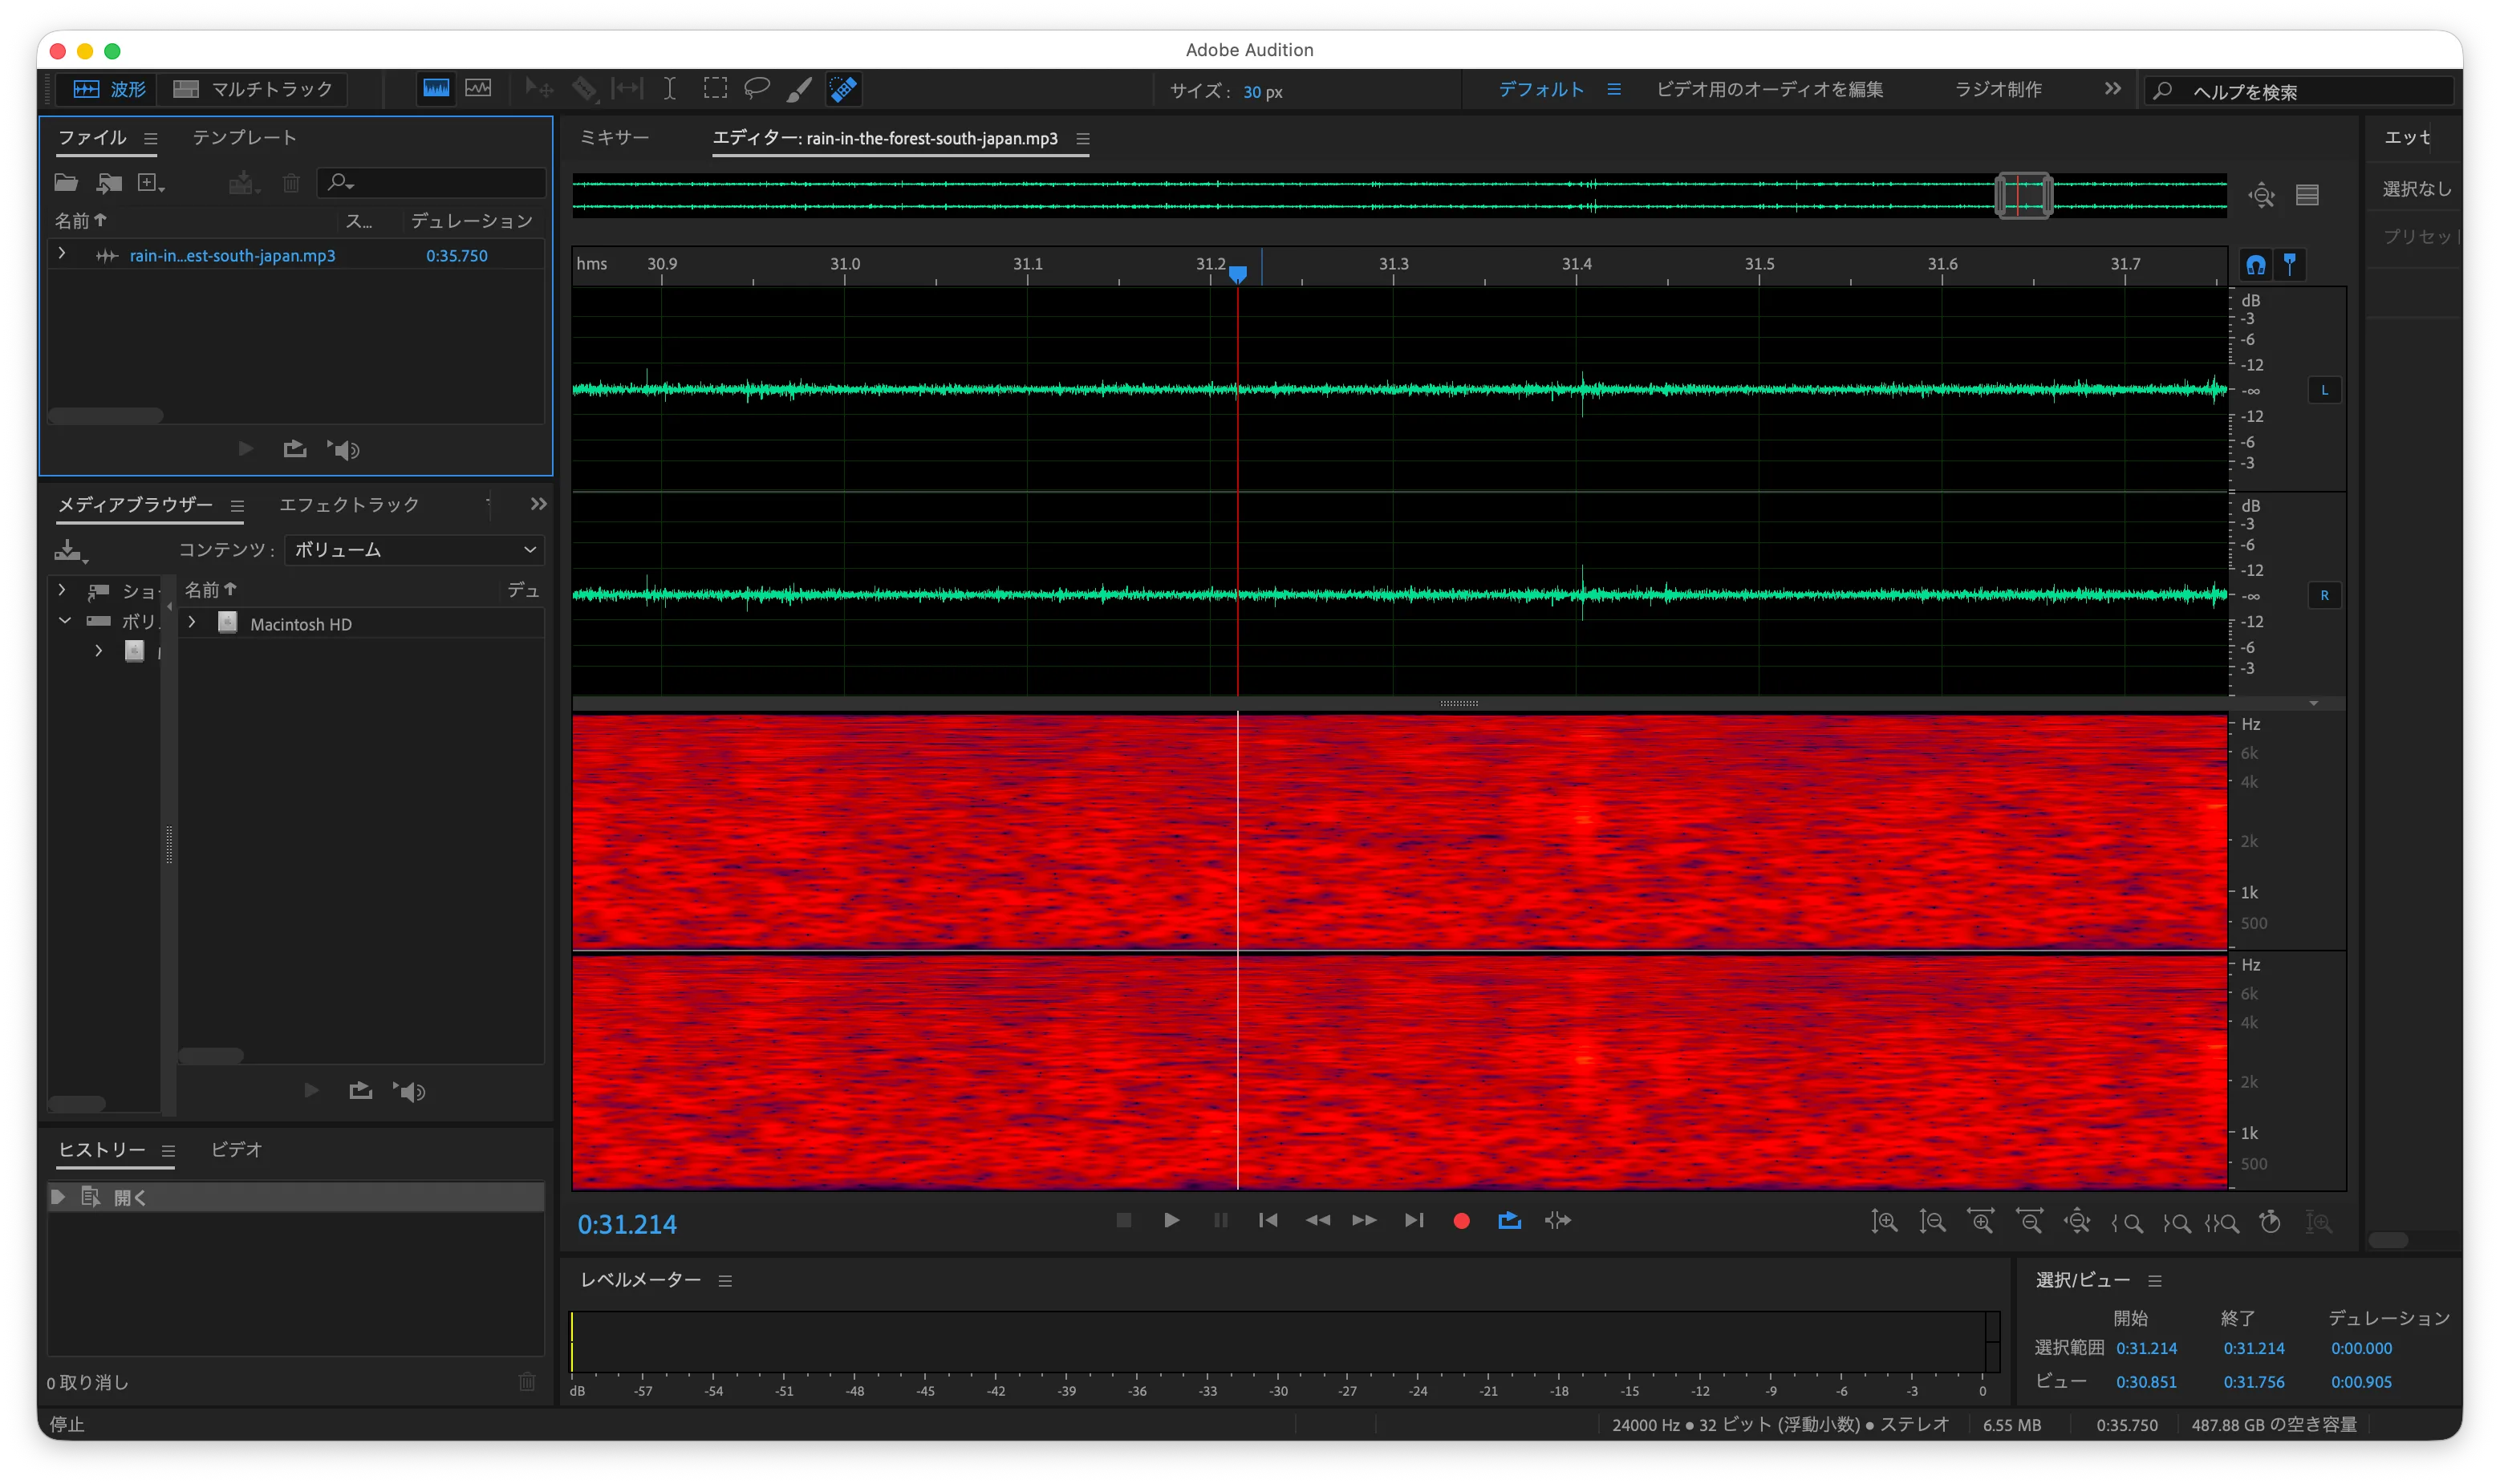
これは実際のAdobe Auditionの作業画面です。再生ヘッドを合わせた31秒過ぎに、厚みのない、線のようなものがかすかに走っているのですが、これが虫の鳴き声です。くっきり出るときもあれば、この画面のようにほとんど見分けがつかないこともあります。目視では見つけづらいので再生しながら耳をすませ変な音が聞こえたら再生ヘッドをそのあたりに戻し、それから目でこの種の線を探してスポット修復ブラシでひとつずつ消していきます。
数十分の音源ファイルを聴きながらの地道な手作業で、自動化できないかと考えたこともありますが、「この雨は屋根に当たっている音か、葉に当たっている音か」「この雨の強さは心地よいか、うるさいか」などの判断は、実際に聴いてみないと判断できないので手作業のままにしています。
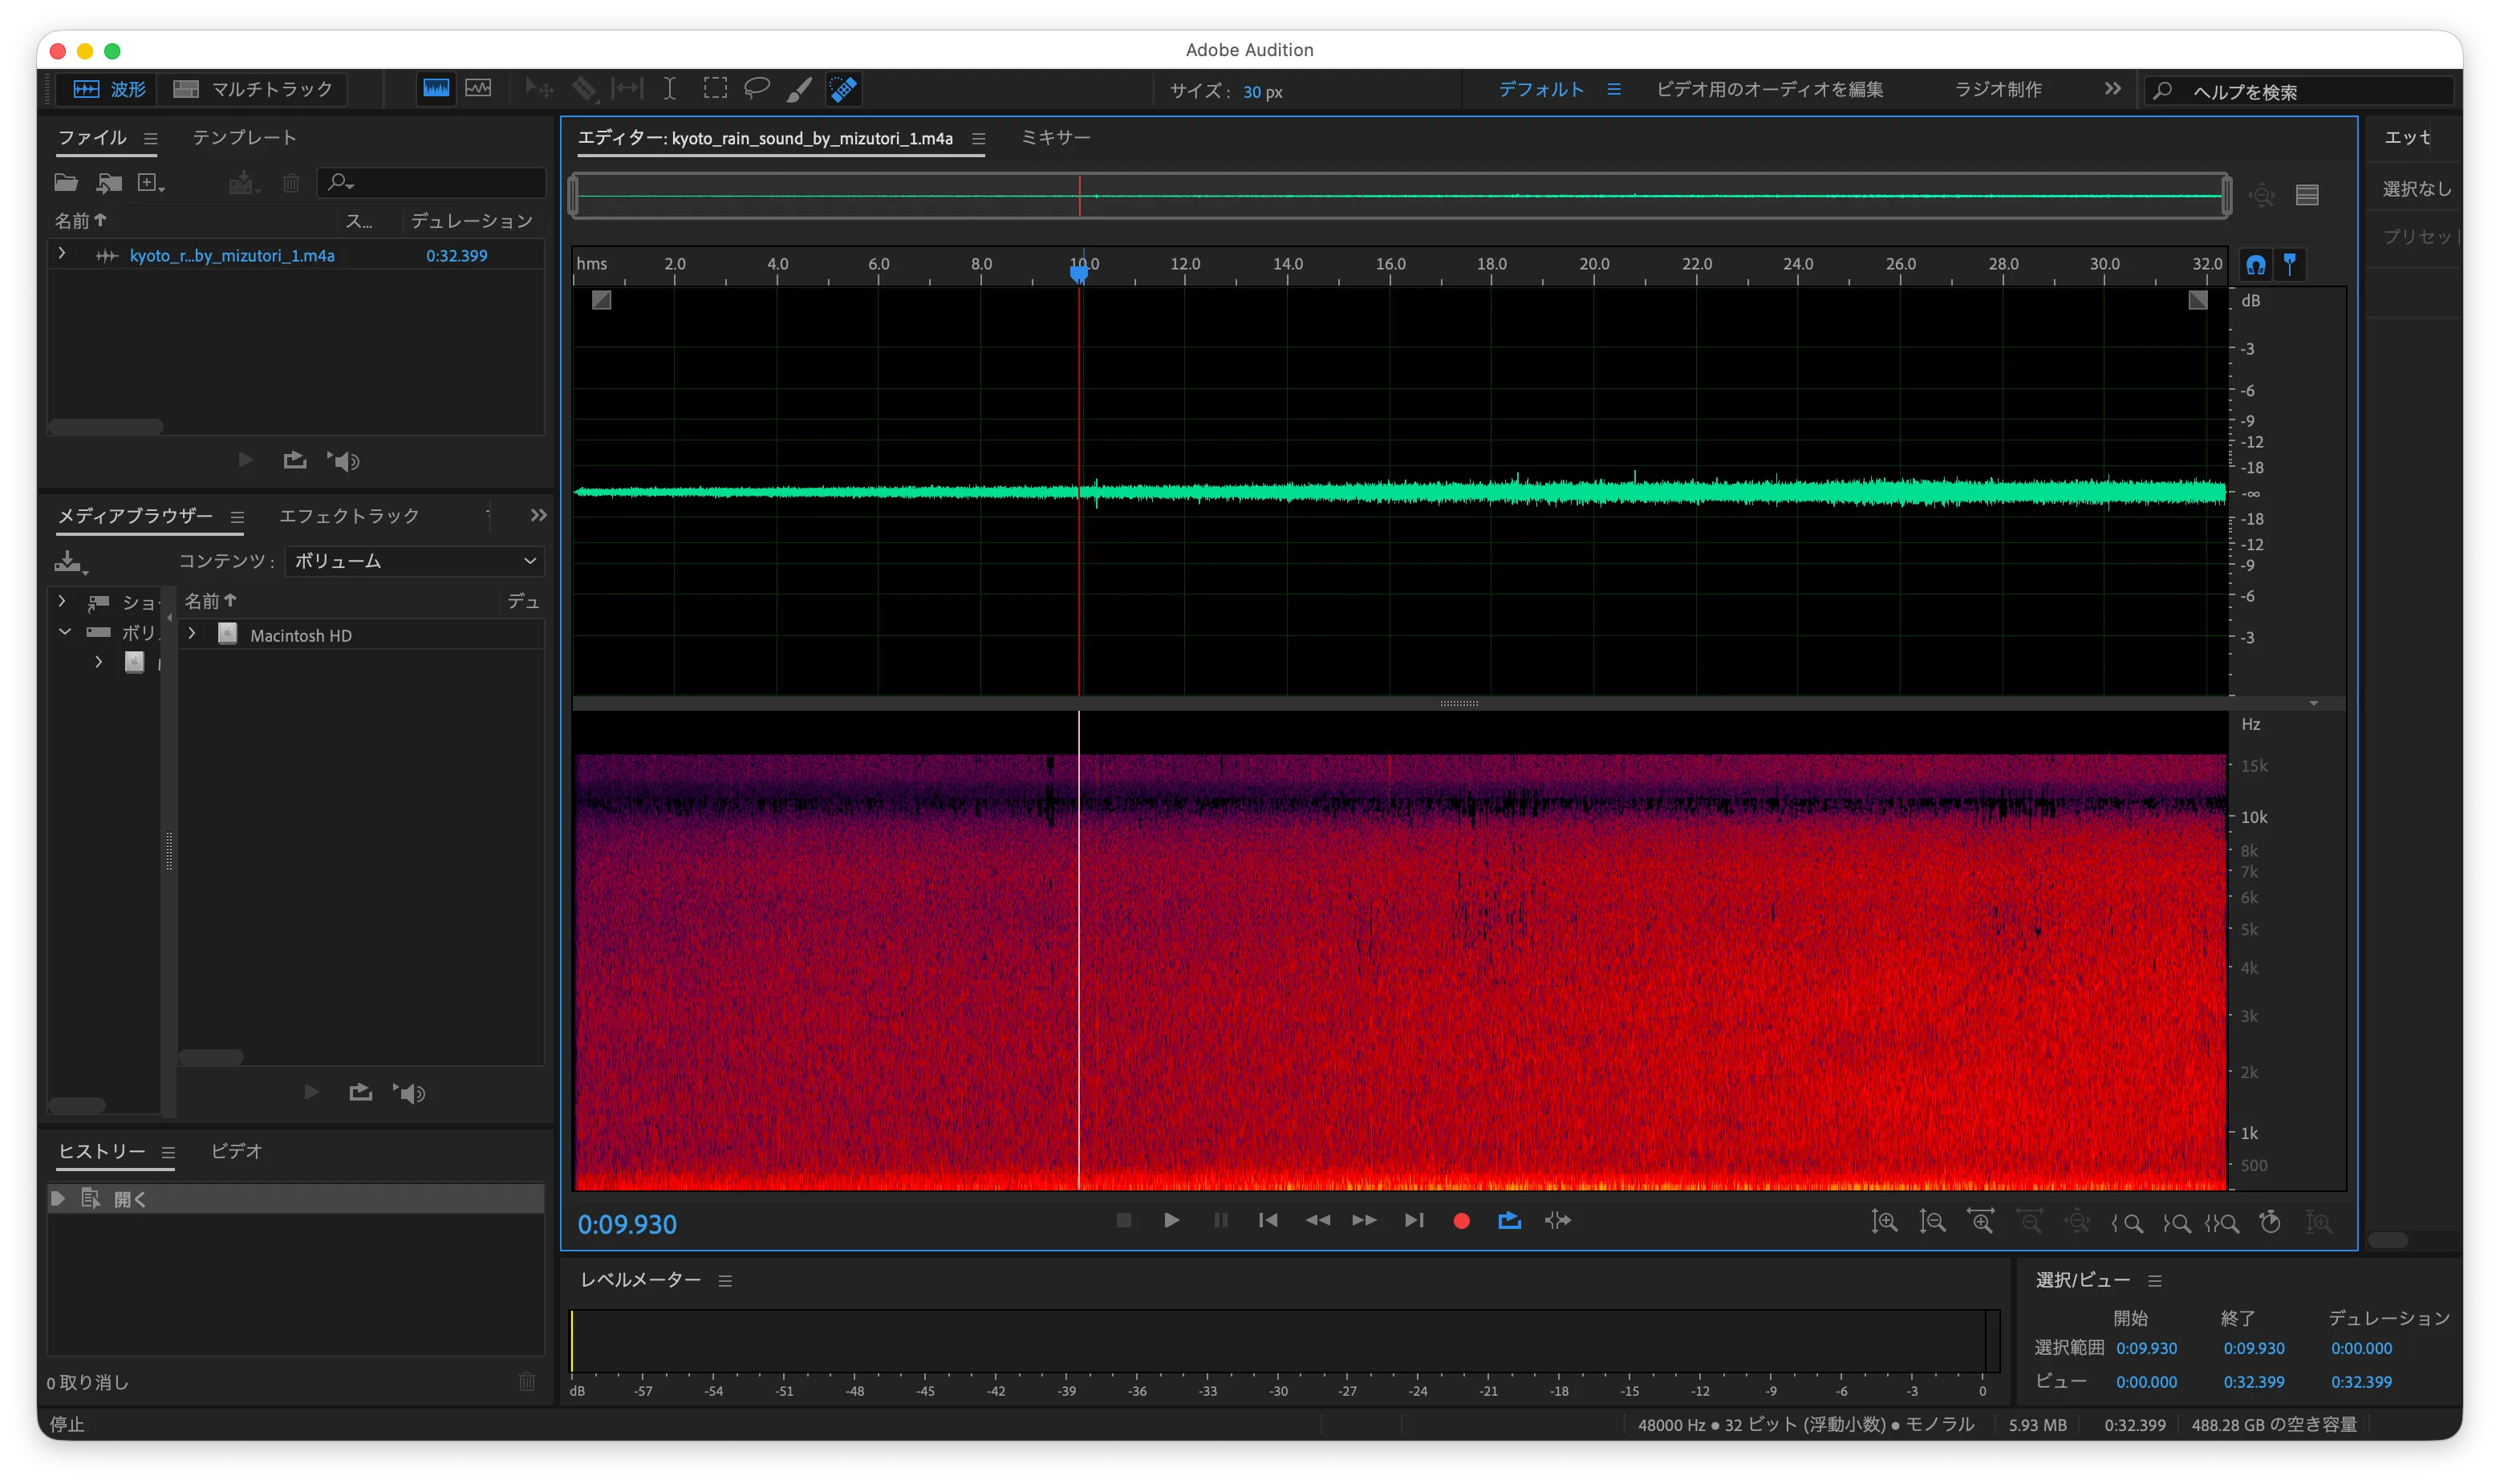
ちなみに、この記事の冒頭に載せた画面に写っているのはまだライブラリに入れていない雨音です。先日、京都の山の中の美術館に向かう山道で大雨に降られ、慌ててiPhoneで録音しました。ロイヤリティフリー音源で始めたライブラリですが、こうして自分で録った雨音もこれから少しずつライブラリに追加していく予定です。
27個の音に耳を頼りにメタデータを振る
パイプラインの中で音源選択を自動化するには、エージェントが「このシーンに合う雨音」を選べるようにする必要があります。そのために作ったのが、音源ライブラリのメタデータでした。
27個の音源ファイルをひとつひとつ耳で聴いて、YAMLフォーマットのファイルに「合いそうな時代」「シーン」「季節」「雨の強さ」を書いていきました。江戸の長屋の軒先に合う音と、平安の寺院の庭に合う音は違います。この耳での分類を先にやっておき、エージェントが era: 江戸, season: 夏, rain: しとしと という入力から適切な音源を自動で選ぶように設計しました。
このようにして自動化の中に人間の判断を置いたのです。 エージェントパイプラインというとすべてエージェントが我が知能を駆使して音を選んでいるように見えるかもしれませんが、実体は、私が聴いて書いたメタデータを参照したシンプルな意思決定です。AIエージェントの導入で成果が出る領域はこういった構造を含んでいると思います。判断そのものを機械化するのではなく、判断を一度だけ丁寧に下して、機械が参照できる形に固定するのです。
ちなみにこのライブラリ周辺ではエラーの出ない失敗に後から気づくこともありました。
シーンIDの命名規則が音源フィルタの入力になっていて、jomon を間違えてjyomon とスペルミスした1本の動画だけ時代フィルタが外れて、時代に合わない音源が選ばれていたり、
あとから追加した9個の音声ファイルを置く場所を間違えてライブラリから見えない状態になっていたり。
人間の判断を機械に渡す部分はヒューマンエラーも出やすい箇所なので従来のソフトウェアと同じように必ずランタイムや動作履歴の定期的なチェックは引き続き重要です。
人間の確認をどこに置くか
このプロジェクトには2本のパイプラインがありますが、人間の関与のさせ方は正反対です。
長尺パイプラインには、制作の途中に人間のゲートが3つあります。3枚生成された画像から1枚を選ぶ。動画プロンプトを承認する。生成されたクリップを承認する。1本の動画に数時間かけるので、途中の分岐点で人間の目を通す価値があります。
ショート版パイプラインは、このゲートをすべて削除しました。画像の選定もAIがやります。12ステップが無人で流れ、最終結果がYouTube Studioに非公開の下書きとして到達します。人間は最後にそこでレビューして、公開ボタンを押すだけです。
ショート版ではゲートを移動し、パイプラインはヒューマンチェックなしで回せるものになりました。途中にヒューマンチェックが要るパイプラインは無人化できませんが、最後に1つだけにすることでAIとヒューマンの同期が必要なくなり、最後にまとめてレビューできる良さがあります。
これとは逆の教訓を得たケースもあります。一晩で23.82ドルを溶かした事故の最終的な解決法は、「数時間かかる処理の完了をエージェントに監視させる」のをやめて、終わった頃に人間が Resume と一言送る設計に変えることでした。人間の一押しをひとつ足したら、ポーリングという概念そのものが消えて、パイプラインのコストもアーキテクチャも改善しました。ヒューマンをあえて中に入れることで逆にシンプルになるパターンです。
どちらのケースでも、一番安く効果的で確実なヒューマンチェックはどこか、という考えに作りながら設計思想が一本化されていきました。
最後の確認でヒューマンがやる仕事
では、最後に残ったレビューゲートで人間は何をしているのか。8月、ショート版パイプラインが作ってきた動画をまとめてレビューしたとき、私は11件の欠陥をファイルに書き出すことにしました。抜粋すると、
- 雨の跳ねが一瞬強すぎて、水道管が破裂したような水しぶきになっている。動画生成からやり直し
- 建物(特に入口)の建築が不自然。画像生成からやり直し
- 構図は完璧だが、行灯の上から炎が吹き出している。行灯の火は行灯の中にあるもの
- 猫が尻尾を動かした瞬間、尻尾が2本になっている
- このシーンは、ただ暗くて、観ていて楽しくない。画像生成からやり直し
11件のうち、パイプラインのインフラ起因のものはゼロでロジックはもう安定しています。残っている問題はすべて、美的か、物理的か、歴史的なものです。
そして最後の1件のフィードバック、「ただ暗くて、楽しくない」、には、技術的な欠陥が何もなく、壊れてもいないのに、ただ良くない、そう思いました。この主観的な「よくない」という判断を下す自動チェックは今のところ存在しません。これが、全自動化の果てにヒューマンに残った仕事の正体かもしれません。
このレビューで効いている知識もモデルの中にはないものばかりでした。行灯の炎は行灯の中にある。縁側は1階の建築要素だから「二階の縁側」というプロンプトは矛盾している。ガラスのランプは戦国の茶屋には存在しない。猫が日本に来たのは奈良時代ごろ(仏典を鼠から守るために船に乗ってきたと言われます)なので、縄文・弥生のシーンに猫は出せない——。歴史チャンネルの品質は、最終的にこういう知識の集積で決まります。
まとめ ― 「Human in the loop」はもちろん妥協ではない
全自動化を目指したプロジェクトの記録として振り返ると、人間の仕事は減ったというより、濃縮されたという方が近いと思います。
- 判断の集積化 — 27個の音源への耳でのメタデータ付けのように、一度だけ丁寧に下した判断を機械が参照できる形に固定する
- 素材の底上げ — Adobe Auditionでの整音のように、自動化のなかに置く素材の品質を人間の手で保証する
- 最後のヒューマンゲート — 「良いか、良くないか」という、定義できないが一瞬で分かる判断を、一番安い位置(=最後にまとめて)で下す
Human in the loopというのは、自動化しきれなかった部分の言い訳や妥協ということではなくて、パイプラインの品質がどこから来るかを決める設計なのだと、作ってみて感じています。
AIエージェントの業務導入で「どこを自動化し、どこに人の質を加えるか」を考えている方は、お気軽にご相談ください。